Pourquoi des prédictions probabilistes ?
Pourquoi des prédictions probabilistes ?
Certaines informations utiles n’existent pas pour tous les bâtiments : on ne sait pas toujours si les murs d’un immeuble sont isolés, comment il est chauffé ni qui l’occupe. Pour combler ces trous, la BDNB utilise des modèles de prédictions statistiques qui s’appuient sur les bâtiments mieux connus (par exemple ceux qui ont un DPE ou un audit) pour en déduire les caractéristiques des autres, c’est ce qu’on appelle l’apprentissage supervisé.
Un modèle ne peut pas être sûr de lui à 100%. Plutôt que de donner une seule réponse, ou seulement la plus probable, la BDNB publie donc, pour chaque bâtiment, la probabilité de chaque réponse possible. C’est comme une prévision météo : « 70 % de pluie » en dit plus qu’un simple « il pleuvra ».
Exemple : pour un bâtiment, les murs sont « isolés par l’intérieur » avec 53 % de chances, « non isolés » avec 5 %, et ainsi de suite. La réponse la plus probable est « isolés par l’intérieur », mais ce n’est pas une certitude.
Nos probabilités sont calibrées, c’est-à-dire que si on prend tous les bâtiments pour lesquels le modèle prédit 70 % de chances d’avoir des murs isolés, environ 70 % d’entre eux ont effectivement des murs isolés.
Pour passer directement à des cas pratiques, voir quelques recettes exploitant les prédictions probabilistes :
- Compter les bouilloires thermiques : sommer des probabilités pour obtenir un effectif attendu ;
- Compter les populations exposées : estimer les personnes concernées par une surchauffe estivale élevée ;
- Croiser des prédictions avec les tirages aléatoires : réaliser des analyses croisées avec les variables
random; - Comment compter les passoires énergétiques : effectifs attendus par étiquette DPE.
Pourquoi ne pas utiliser uniquement les prédictions les plus probables sur chaque bâtiment?
1. Une prédiction « au plus probable » déforme le parc. Si, pour chaque bâtiment, on retient la modalité la plus probable, on obtient une distribution différente de celle du parc réel : les modalités minoritaires disparaissent alors qu’elles existent bien. Pour éviter ce phénomène de sous-estimation des classes rares, il suffit de sommer les probabilités sur l’ensemble des bâtiments pour obtenir une image fidèle du parc considéré.
2. L’incertitude est une information. Un bâtiment à 51 % et un bâtiment à 99 % de chances d’être en étiquette E n’appellent pas la même décision. Publier les probabilités, et non la seule valeur la plus probable, permet de le voir et de qualifier l’incertitude (voir « Quantifier l’incertitude »).
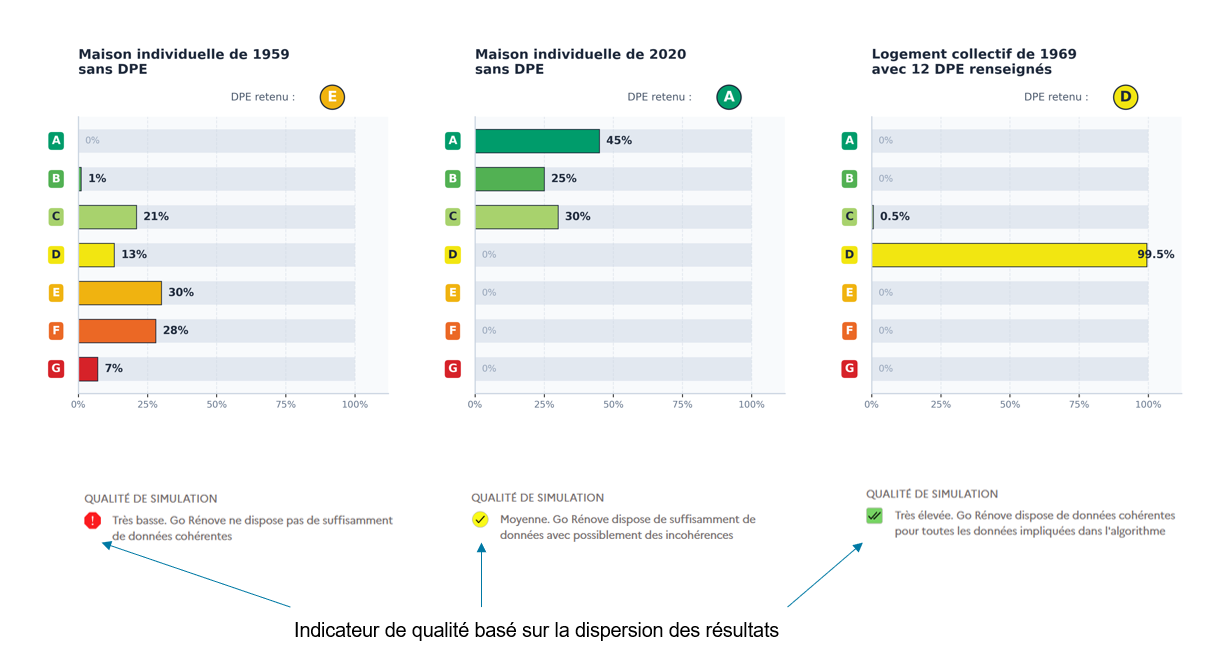
Dans cette figure, on peut noter que le modèle est indécis sur l’état de rénovation de la maison individuelle. Il présente donc une distribution dite « bimodale », c’est-à-dire avec deux maxima de probabilité : l’un sur la classe C (rénovée), l’autre sur la classe E (non rénovée).
Quantifier l’incertitude
Plusieurs indicateurs permettent de juger de la fiabilité d’une prédiction.
Les probabilités elles-mêmes. Une modalité à 99 % est très probable, une modalité à 40 % ne l’est pas. Quand plusieurs modalités ont des probabilités voisines (classe 8 à 46 %, classe 9 à 43 %), la prédiction hésite.
L’intervalle à 95 % (lower, upper) pour les variables numériques. Sa largeur, comparée à la moyenne, indique l’incertitude relative : un intervalle étroit signifie que les tirages convergent.
Le niveau d’incertitude classe_incertitude_*, publié pour l’ISB. Il résume en cinq niveaux (très faible, faible, moyenne, élevé, très élevé) le rapport entre la largeur de l’intervalle à 95 % et la valeur moyenne de l’ISB. Il permet de filtrer ou de pondérer les résultats sans manipuler les bornes. Par exemple, dans les Bouches-du-Rhône, la majorité des bâtiments sont en incertitude « moyenne » ou « très faible » et très peu en incertitude « élevé ».
Ces indicateurs décrivent l’incertitude liée aux données manquantes et au modèle ; ils ne couvrent pas une erreur systématique sur les données sources.
Quatre façons de les utiliser
1. Utiliser les probabilités (effectif attendu)
C’est la méthode à privilégier pour dénombrer des logements sur un territoire. Chaque bâtiment porte une probabilité par modalité ; l’espérance de l’effectif (en logements, en ménages ou en individus) s’obtient en multipliant cette probabilité par la taille du bâtiment, puis en sommant :
\[ E[N] = \sum_{b} n_b \times P_b(\text{modalité}) \]
où \(n_b\) est le nombre de logements du bâtiment (nb_log), le nombre de ménages (poids_menage pour les tables ménages) ou le nombre d’individus (nb_individu). Pour comptabiliser les passoires énergétiques, il suffit de sommer les probabilités des classes F et G pour chaque bâtiment, puis de multiplier par le nombre de logements.
Exemple : un bâtiment de 10 logements avec 60 % de probabilité d’être en classe 9 ou 10 de surchauffe contribue pour 6 logements ; un bâtiment de 20 logements à 5 % contribue pour 1 logement. Le total attendu est de 7 logements, alors qu’aucun des deux bâtiments n’a « exactement » 6 ou 1 logement concerné.
SELECT
    SUM(ffo.nb_log) AS nb_logements,
    ROUND(SUM(ffo.nb_log * (
        isb.prob_isb_canicule_2003_classe_9
        + isb.prob_isb_canicule_2003_classe_10
    ))) AS nb_logements_attendus_classes_9_10
FROM bdnb_v07.batiment_groupe AS bg
JOIN bdnb_v07.batiment_groupe_ffo_bat AS ffo
    ON ffo.batiment_groupe_id = bg.batiment_groupe_id
JOIN bdnb_v07.batiment_groupe_simulations_isb_canicule_2003_proba AS isb
    ON isb.batiment_groupe_id = bg.batiment_groupe_id
WHERE bg.code_commune_insee = '13001'
  AND ffo.nb_log > 0;
À Aix-en-Provence (13001), pour le millésime 2026-02.b, sur 84 065 logements, on attend environ 32 300 logements en classes 9 ou 10. Compter les logements dont la classe top est 9 ou 10 donne 26 800 : l’écart vient des bâtiments dont la classe 9 ou 10 est probable sans être la plus probable. Voir aussi la recette Compter les bouilloires thermiques.
Ouvrir l’animation du parc en grand format.
Dans cet exemple synthétique, les quatre maisons ont le même poids : chacune contribue pour 25 % à la distribution du parc. Les probabilités sont moyennées, pas les classes DPE. Pour une répartition en logements, les poids seraient proportionnels au nombre de logements de chaque bâtiment.
2. Prendre la modalité la plus probable (top)
La variable top n’est pertinente que dans une approche « particulier » : lorsqu’on regarde un bâtiment (ou un individu) précis, elle indique la modalité la plus probable. Elle permet également de visualiser une seule modalité sur une carte.
Elle n’est pas adaptée à une analyse à grande échelle : un bâtiment à 51 % et un bâtiment à 99 % pèsent autant, les modalités minoritaires disparaissent, et la distribution est déformée (ne l’utilisez pas pour filtrer un parc, voir plus bas). Elle ne permet pas de croiser des variables : la combinaison de deux _top n’est pas la combinaison la plus probable (ex: le système de chauffage le plus probable n’est pas forcément celui de la classe DPE la plus probable), et ne correspond à aucune réalisation cohérente. Seules les variables random permettent de croiser plusieurs variables (méthode 3).
3. Utiliser les tirages aléatoires (variables _random)
Les prédictions sont produites par simulation de Monte Carlo : le modèle génère de nombreux tirages plausibles pour chaque bâtiment (ou segment de ménages). Les variables random publient un de ces tirages, et toutes les variables random d’une même ligne et d’une même source proviennent de la même réalisation : elles sont cohérentes entre elles (par exemple l’isolation tirée, le coefficient U des murs tiré et l’ISB-DH tiré d’un même bâtiment). Agrégés sur un territoire, ces tirages respectent la distribution des prédictions et conservent les corrélations : ils conviennent à la réalisation de tableaux croisés à grande échelle. À l’échelle d’un seul bâtiment, cette variable apparaîtra comme très bruitée.
4. Utiliser la distribution complète
Pour propager l’incertitude (intervalles, simulations de Monte Carlo), on utilise toutes les probabilités, ou les tirages *_random répétés. Cette approche est plus coûteuse mais indispensable pour qualifier la fiabilité d’un résultat. Du fait de leur volume (plus de 2 milliards de tirages), les réalisations Monte Carlo ne sont pas redistribuées dans les exports SQL, mais elles sont disponibles sur demande pour des analyses spécifiques.
Filtrer une partie du parc avec un indicateur probabiliste
Pour sélectionner les bâtiments d’un parc selon une prédiction (« les bâtiments en étiquette F ou G », « les plus exposés à la surchauffe »), le réflexe est de filtrer sur la variable top. C’est à éviter : top ne retient que la modalité la plus probable, ce qui déforme fortement la distribution. Une modalité qui n’est jamais la plus probable (souvent les modalités rares) disparaît complètement, et une modalité dominante est surreprésentée. La sélection obtenue ne reflète ni l’effectif réel, ni son incertitude.
Deux approches sont préférables.
Filtrer sur un seuil de probabilité
On additionne les probabilités des modalités recherchées et on garde les bâtiments dont la probabilité dépasse un seuil choisi. Par exemple, pour retenir les bâtiments qui ont au moins 50 % de chances d’être pires que l’étiquette DPE E, c’est-à-dire d’être en F ou G, on somme les probabilités etiquette_dpe_initial_f et etiquette_dpe_initial_g de la table batiment_groupe_simulations_dpe :
SELECT
    bg.batiment_groupe_id,
    sim.etiquette_dpe_initial_f + sim.etiquette_dpe_initial_g AS proba_pire_que_e
FROM bdnb_v07.batiment_groupe AS bg
JOIN bdnb_v07.batiment_groupe_simulations_dpe AS sim
    ON sim.batiment_groupe_id = bg.batiment_groupe_id
   AND sim.code_departement_insee = bg.code_departement_insee
WHERE bg.code_commune_insee = '21231'
  AND sim.etiquette_dpe_initial_f + sim.etiquette_dpe_initial_g >= 0.5
ORDER BY proba_pire_que_e DESC;
Le seuil exprime un compromis :
- un seuil élevé (80 %) donne une liste restreinte de bâtiments très probablement concernés (peu de faux positifs, mais beaucoup d’oubli) ;
- un seuil bas (20 %) donne une liste large qui contient presque tous les bâtiments concernés (peu d’oublis, mais beaucoup de faux positifs).
Le choix dépend de l’usage : cibler un courrier ou une visite de terrain appelle un seuil élevé, un repérage large un seuil bas. Dans tous les cas, la liste produite est une sélection de bâtiments à vérifier, pas un décompte. Sur Dijon (21231), pour le millésime 2026-02.b, 2 537 bâtiments (7 716 logements) dépassent le seuil de 50 % pour F ou G, alors que l’effectif attendu en F ou G, obtenu en sommant les probabilités, est d’environ 9 513 logements : le seuil sous-estime l’effectif total, car il écarte les bâtiments à 30 % ou 40 % de chances qui pèsent ensemble dans le total.
Pour compter, ne comptez pas les bâtiments qui dépassent un seuil : sommez les probabilités (effectif attendu). Le seuil sert à sélectionner des bâtiments, pas à les dénombrer.
Filtrer sur le tirage aléatoire, sur un échantillon important
Le filtre sur *_random est acceptable parce que le tirage respecte la distribution des probabilités : sur un grand nombre de bâtiments, la part de bâtiments sélectionnés est correcte en moyenne. Il faut en revanche que l’échantillon soit important (un territoire, pas un parc de quelques dizaines de bâtiments) : à petite échelle, le tirage d’un bâtiment donné peut être très éloigné de sa modalité la plus probable, et la sélection n’a pas de valeur individuelle. Le filtre random convient donc à des statistiques sur un grand parc, jamais à l’identification d’un bâtiment précis, ni aux représentations cartographiques à l’échelle bâtiment.
| Besoin | Méthode |
|---|---|
| Identifier des bâtiments à traiter | Seuil de probabilité |
| Compter des logements | Somme des probabilités (effectif attendu) × le nombre de logements par bâtiment |
| Répartition ou tableau croisé sur un grand parc | Variables random |
| Affichage individuel ou repérage rapide sans enjeu de distribution | top, avec prudence |
Bonnes pratiques
- Agréger avant d’interpréter : une prédiction est plus fiable sur un ensemble de bâtiments que sur un bâtiment isolé.
- Contrôler la couverture : les bâtiments sans prédiction ne sont pas des bâtiments « sans risque » ; ils sont simplement absents.
- Tenir compte de l’incertitude publiée quand elle existe (par exemple
classe_incertitude_isb_canicule_2003). - Ne pas présenter une modalité
topcomme une donnée observée : c’est un résultat de modèle, à citer comme tel.
Comment sont générées nos prédictions ?
Nos indicateurs probabilistes répondent à un cahier des charges en cinq points :
- reconstruire chaque bâtiment (ou ménage) le plus fidèlement possible
- estimer l’incertitude de chaque prédiction en prenant en compte le niveau d’information réellement disponible sur celui-ci
- donner une image fidèle du parc, quelle que soit l’échelle d’agrégation (bâtiment, îlot, quartier, commune, département, région…)
- permettre d’évaluer l’impact de modifications (gestes de rénovation, changement de climats…)
- maîtriser la covariance entre variables
Dans la BDNB, deux prédictions sont à la source de tous les indicateurs probabilistes :
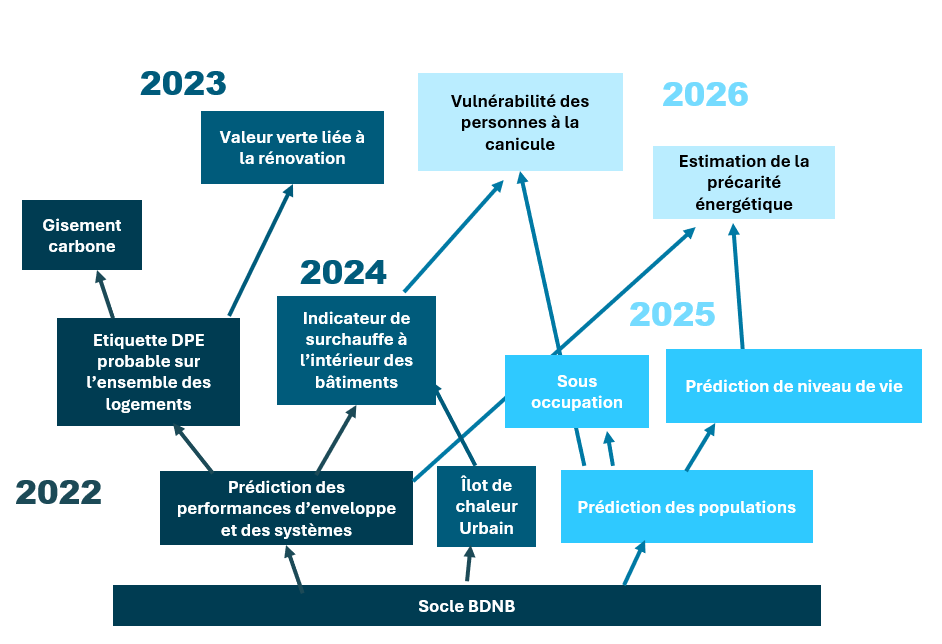
- les prédictions des performances de l’enveloppe thermique et des systèmes
batiment_groupe_imputation_enveloppe_et_systemes_proba - les prédictions des individus probables dans les logements
menage_prediction_socio_eco_proba
Tous les autres indicateurs probabilistes reposent sur ces tirages afin d’estimer leurs incertitudes :
- Prédiction de classes DPE avant et après rénovation
batiment_groupe_simulations_dpe - Surchauffe dans les bâtiments (ISB)
batiment_groupe_simulations_isb_canicule_2003_proba - Niveau de vie et taux d’occupation
menage_prediction_socio_eco_proba - Gain de valeur foncière après rénovation énergétique
batiment_groupe_simulations_dvf - Précarité énergétique (travaux en cours de validation terrain)
- Isolement acoustique de façade et niveau de bruit intérieur (travaux en cours)
La propagation d’incertitude désigne le processus par lequel les incertitudes associées aux variables d’entrée d’un modèle ou d’un calcul se répercutent sur les résultats de ce dernier. Elle vise à quantifier comment les erreurs, approximations ou variabilités dans les données ou les paramètres initiaux influencent les prédictions ou estimations produites.
Un indicateur calculé à partir de plusieurs données incertaines (étiquette DPE, surchauffe, précarité) hérite de leurs incertitudes. Pour les estimer, on répète le calcul sur des réalisations complètes des données d’entrée, selon la méthode de propagation par Monte Carlo décrite dans le supplément 1 au GUM (Joint Committee for Guides in Metrology 2008b), qui complète le guide (Joint Committee for Guides in Metrology 2008a). Les variables étant liées entre elles, les tirer indépendamment fausse le résultat. Prenons une surface \(S = L \times H\) : si \(L\) et \(H\) sont corrélés (par exemple, un bâtiment plus long est aussi plus haut), les tirer indépendamment sous-estime ou sur-estime l’incertitude de \(S\) selon le signe de la corrélation. La BDNB publie donc des tirages cohérents : toutes les variables random d’une même ligne et d’une même source viennent d’une même réalisation.
Pourquoi passer par la performance du bâti et ne pas directement prédire des classes DPE “par IA”?
Le DPE est un indicateur composite, calculé à partir de plusieurs variables (isolation, vitrage, chauffage, climat…) et dont la méthode de calcul évolue. Par exemple, les modifications successives du coefficient d’énergie primaire font mécaniquement changer de classe les logements chauffés à l’électricité. Il est plus robuste de prédire ces variables séparément, puis de calculer le DPE à partir de ces prédictions. Cela permet aussi d’estimer l’incertitude de prédiction sur le DPE.
L’animation suivante illustre de manière simplifiée la propagation d’incertitude des performances du bâtiment aux classes DPE. L’isolation, le vitrage et le chauffage varient à chaque tirage suivant les probabilités du modèle de prédiction des performances. Chaque tirage sert à réaliser un calcul DPE. Dans notre cas, nous utilisons 17 variables de performance prédites pour le calcul DPE.
Ouvrir l’animation en grand format.
C’est à partir de ces résultats que la BDNB publie des résumés : la moyenne, un intervalle qui contient 95 % des résultats, les probabilités de chaque classe, et un tirage unique.
Illustration : la prédiction de population et de revenus
La prédiction de population applique ce principe en deux temps.
Étape 1 : tirer des individus représentatifs. Les logements des Fichiers fonciers (résidences principales) sont regroupés par bâtiment en groupes de logements identiques (surface, nombre de pièces, statut d’occupation, HLM). Pour chaque groupe, un modèle tire 100 ménages plausibles (taille du ménage, âge, etc.) : c’est le tirage de Monte Carlo.
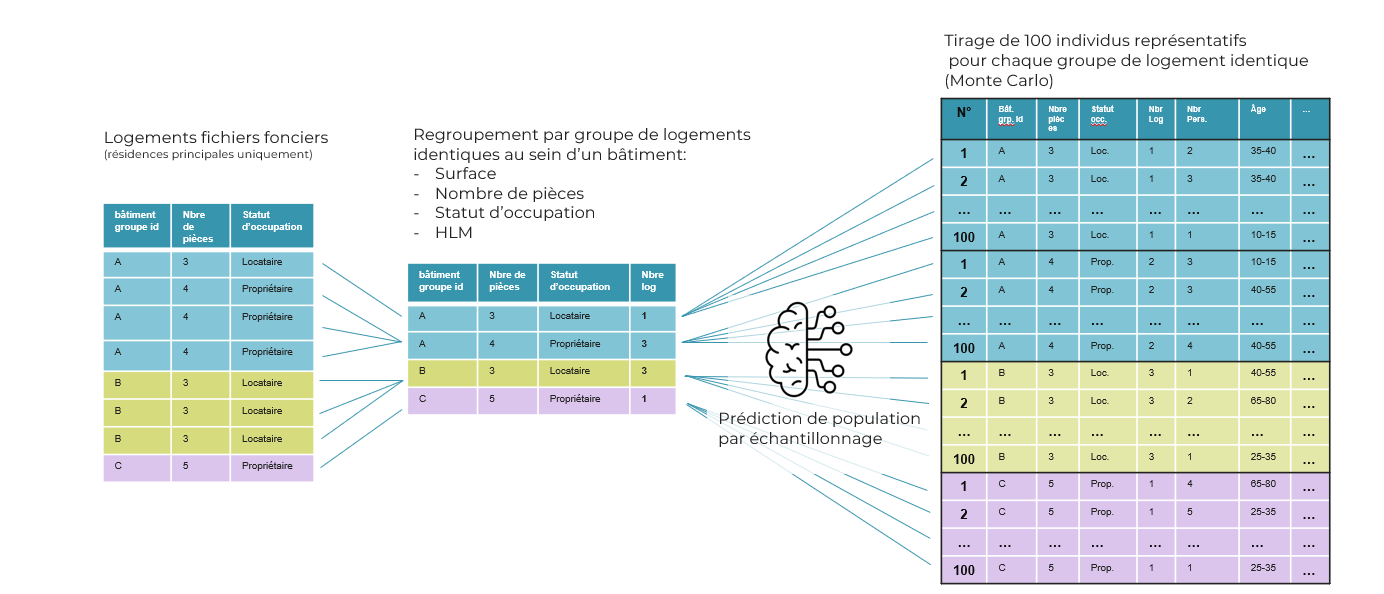
Étape 2 : propager l’incertitude et agréger. Chaque ménage tiré sert ensuite d’entrée à un second modèle (ici, la prédiction du revenu disponible). On obtient 100 revenus par groupe de logements, qui sont ensuite agrégés par bâtiment : les tirages deviennent des probabilités par modalité (par exemple la probabilité d’un ménage de 1, 2 ou 3 personnes), une moyenne et des déciles.
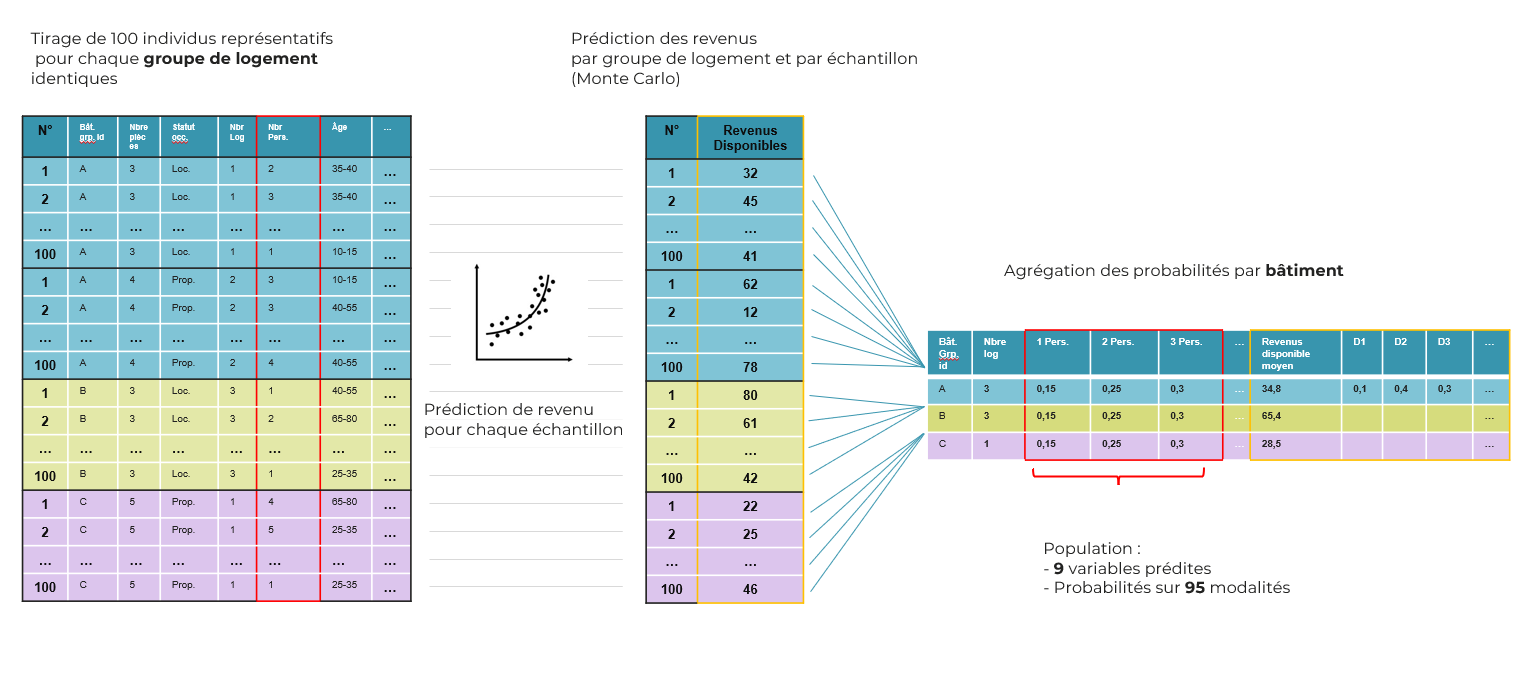
Au total, la prédiction de population porte sur 9 variables et des probabilités sur 95 modalités. Les variables *_random correspondent à un de ces ménages tirés, ce qui explique leur cohérence entre elles (voir plus bas).
Pour aller plus loin
- Les prédictions probabilistes de la BDNB : présentation, IBPSA France 2026 (PDF).
- Simulation du gisement de rénovation énergétique et carbone du parc résidentiel français avec la BDNB : article, IBPSA France 2026 (PDF), et sa présentation.
- Toutes les publications : page Publication.
Annexe technique : justification des tirages selon la distribution conditionnelle
On cherche à prédire \(Y\) pour chaque individu d’une population, connaissant \(X\) (par exemple, pour chaque bâtiment, les données connues \(X\) et les données manquantes \(Y\)). On suppose la loi jointe \(P(X, Y)\) connue. La distribution de la variable réelle sur la population est :
\[ P(Y) = \int P(Y \mid X)\, P(X)\, dX \]
On cherche des prédictions \(\hat{Y}_i\) telles que \(\hat{Y}\) ait la même distribution que \(Y\) :
\[ P(\hat{Y}) = \int P(\hat{Y} \mid X)\, P(X)\, dX \]
Cette égalité est vérifiée si, pour chaque bâtiment \(i\) de données connues \(X_i\) :
\[ \hat{Y}_i \sim P(Y \mid X_i) \]
Autrement dit, on tire \(\hat{Y}_i\) dans la distribution conditionnelle, plutôt que de prendre sa valeur la plus probable \(\arg\max_y P(y \mid X_i)\) (la variable top). Ce choix retourne toujours la même modalité pour deux bâtiments identiques en \(X\) : la distribution obtenue sur la population est alors concentrée sur les modalités majoritaires et diffère de \(P(Y)\).
Comment les tables restituent les résultats de manière probabiliste
Dans la BDNB, une variable issue d’une prédiction probabiliste (tirage Monte Carlo) n’est pas résumée par une valeur unique, mais par plusieurs statistiques descriptives. Chaque phénomène incertain est décliné dans les tables sous trois formes complémentaires, identifiables par le suffixe des colonnes :
*_mean) encadrée par les bornes de l’intervalle de prédiction à 95 % (*_loweret*_upper, laissant 2,5 % des tirages de chaque côté) et parfois l’écart-type (*_std).*_topou*_mean) : la modalité la plus probable pour ce bâtiment pris isolément (ou la moyenne pour une grandeur continue).*_random) : un tirage unique extrait de la simulation de Monte Carlo. Toutes les colonnes*_randomissues d’une même chaîne de modélisation (par exemple l’isolation tirée, le coefficient \(U\) tiré et l’indicateur de surchauffe tiré d’un même bâtiment) proviennent de la même itération du tirage et préservent donc les corrélations physiques entre variables.Lecture comparée sur trois bâtiments
L’extrait simplifié ci-dessous (classes de surchauffe estivale ISB, restreint aux classes 7 à 10) illustre comment ces colonnes se complètent :
_top_random_topmasquerait cette incertitude, ainsi que le risque non nul (10 %) que le bâtiment appartienne à la classe 10._random(Bâtiment B) : le tirage aléatoire a retenuclasse_10(qui avait 10 % de chances de sortir).1,00(et pour une variable quantitative, les bornes_loweret_uppersont strictement égales à_mean).Vous n’avez pas besoin de croiser manuellement les tables de prédictions avec les tables de données observées (DPE ADEME, Fichiers fonciers, RNC…) pour récupérer l’information existante : les données connues sont directement intégrées aux simulations et conditionnent les probabilités publiées.
Selon la nature de la variable, la présence d’une donnée source se traduit de deux façons dans la table :
1,00(et0,00pour toutes les autres), et les colonnes*_topet*_randomsont identiques.*_lower=*_mean=*_upper=*_random).Le nom exact des colonnes varie selon les millésimes et les tables (certaines préfixent les probabilités par
prob_, d’autres utilisent directement le nom de la modalité commeetiquette_dpe_initial_f). Consultez la documentation de référence des tables concernées :batiment_groupe_imputation_enveloppe_et_systemes_probabatiment_groupe_simulations_dpebatiment_groupe_simulations_isb_canicule_2003_probamenage_prediction_socio_eco_probabatiment_groupe_simulations_dvf